Una línea pequeña junto a un punto puede cambiar por completo la lectura de un gráfico sobre tirzepatida. Antes de decidir si el resultado parece preciso, conviene identificar qué representa cada elemento: una observación, una media, la variación entre observaciones o la incertidumbre de una estimación. Esas cantidades pueden compartir unidades y aparecer en el mismo eje, aunque respondan preguntas diferentes. La guía sobre expectativas y promedios de los estudios introduce la distancia entre un resumen colectivo y una experiencia personal. Aquí examinamos el mecanismo estadístico que explica esa distancia y por qué el tamaño de una barra requiere una definición.
La palabra error también puede confundir. En estadística, un error estándar no es una cuenta de equivocaciones ni una medida directa de la calidad del trabajo. Describe una forma específica de variabilidad: cuánto cambiaría una estimación al obtener nuevos datos mediante un procedimiento comparable, bajo determinados supuestos. Para entenderlo, seguiremos ejemplos hipotéticos de mediciones sin significado clínico y separaremos sus cálculos de los resultados publicados. El objetivo es reconocer el objeto que se estima, las condiciones de la fórmula y la información que sigue faltando incluso cuando una cifra parece muy exacta. Una buena lectura conserva esas tres piezas juntas.
Antes de interpretar una barra
Un punto central indica una ubicación en el eje. La línea que lo acompaña añade información definida por quien construyó el gráfico: podría mostrar dispersión, error estándar o un intervalo calculado con otro criterio. Para leerla, hay que conectar la leyenda con la variable, sus unidades y el momento de medición. La geometría no reemplaza esa definición. Incluso un símbolo perfectamente dibujado puede quedar estadísticamente indeterminado si falta el nombre de la cantidad representada. Además, cambiar la escala visual modifica la impresión de amplitud sin cambiar necesariamente la incertidumbre numérica.
Conviene distinguir la pregunta sobre dónde se concentra un conjunto de datos de la pregunta sobre cuánto se separan sus observaciones. Después aparece otra: cuánto variaría el resumen si el proceso de obtención de datos se repitiera. Esta última exige imaginar muestras alternativas, aunque solo dispongamos de una muestra real. La separación entre lo registrado y lo resumido también organiza la lectura de Semaglutida: alguna vez no significa ahora. Aquí la atención está en el objeto estadístico: intercambiar una medida de dispersión por una de precisión cambia la pregunta, aunque el dibujo conserve exactamente su apariencia.
Una media seleccionada y su contexto
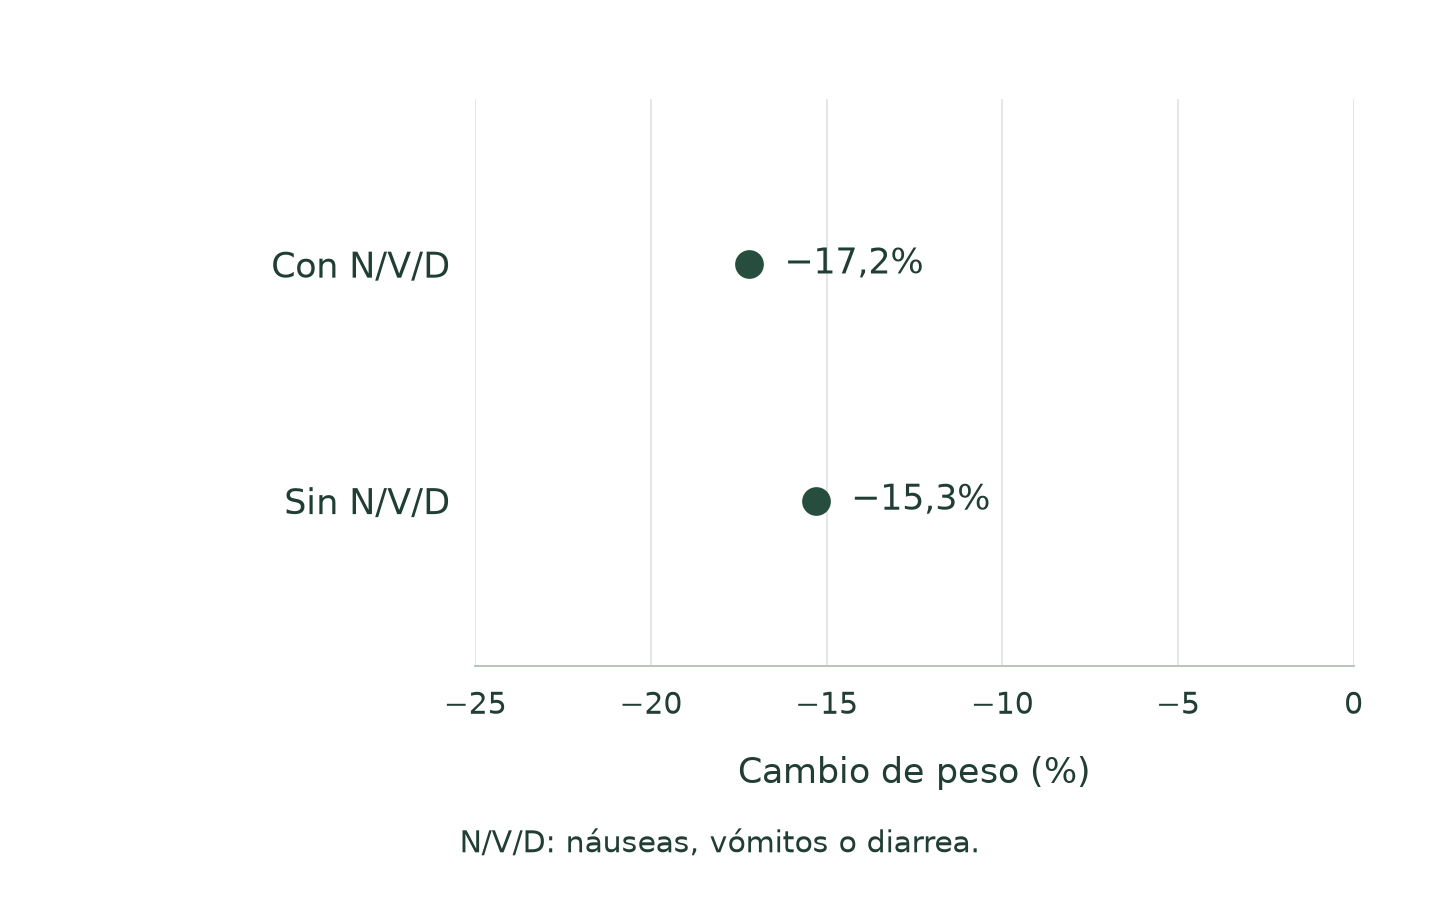
En SURMOUNT-1, adultos con obesidad o sobrepeso sin diabetes tipo 2 recibieron tirzepatida subcutánea semanal o placebo durante 72 semanas. Este análisis posterior incluyó participantes aleatorizados que recibieron al menos una dosis y excluyó datos posteriores a suspender el tratamiento. Los subgrupos por náuseas, vómitos o diarrea no fueron aleatorizados. Presentó medias ajustadas y barras de error estándar. Eli Lilly financió el estudio.
Para interpretar cualquier resumen publicado, la identificación del objeto viene antes de la aritmética. Una media necesita una variable, una población de referencia y una regla de cálculo. Una medida de incertidumbre necesita además un procedimiento que la produzca. Tener solo la ubicación del punto no permite deducir la amplitud de un intervalo: conjuntos de datos y modelos diferentes pueden generar el mismo centro con precisiones diferentes. Completar una información ausente mediante una suposición visual produce un resultado nuevo, cuya validez habría que demostrar por separado.
También importa separar una descripción de una comparación causal. En términos generales, organizar observaciones según una característica y describir sus medias no especifica qué intervención habría cambiado esa característica. El cálculo puede ser exacto y la pregunta causal seguir sin respuesta. Por eso, la lectura comienza por identificar qué se resumió y termina donde acaba la información disponible. La precisión numérica pertenece a una estimación definida; no transforma automáticamente una asociación en una explicación de sus causas.
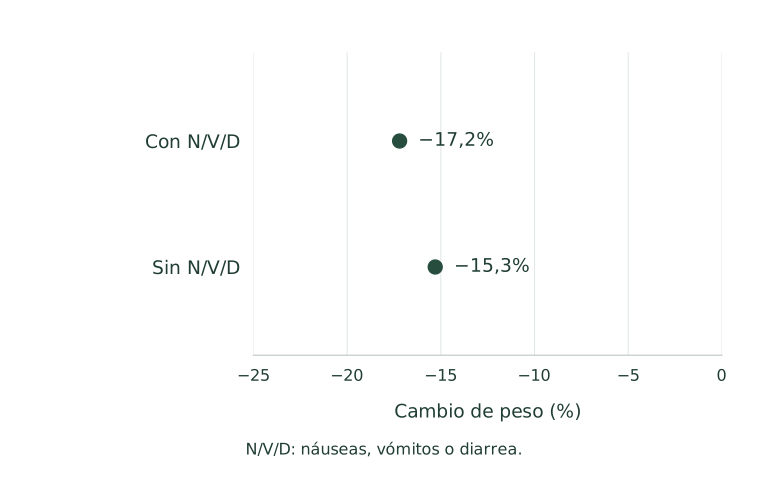
Dos medias ajustadas
Tirzepatida 5 mg, SURMOUNT-1. Sin barras de error: no estimamos su tamaño desde la imagen. [2]
Si la tabla supera el ancho de pantalla, desplázala horizontalmente. Con el teclado, enfócala y usa las flechas.
| Subgrupo | Media (%) |
|---|---|
| Con N/V/D | −17,2 |
| Sin N/V/D | −15,3 |
Fuentes: [2]
La dispersión pertenece a las observaciones
Consideremos un ejemplo hipotético de una medición abstracta, expresada en unidades, tomada una sola vez por objeto en un momento común y bajo el mismo procedimiento. Una colección contiene 8, 10 y 12 unidades; otra contiene 2, 10 y 18. Ambas tienen media de 10 unidades: sus sumas son iguales y contienen la misma cantidad de observaciones. Sin embargo, las distancias respecto del centro son distintas. En la primera colección los extremos quedan cerca de la media; en la segunda se alejan más. La media conserva la información sobre el centro aritmético, pero no describe por sí sola cómo se distribuyen las mediciones a su alrededor.
En ese ejemplo hipotético, las desviaciones respecto de la media suman cero porque las distancias negativas y positivas se cancelan. Elevarlas al cuadrado evita esa cancelación: la suma de cuadrados es 8 en la primera colección y 128 en la segunda. Para calcular la varianza muestral dividimos cada suma entre n menos uno, aquí 2; obtenemos 4 y 64 unidades cuadradas. La raíz cuadrada devuelve las unidades originales: las desviaciones estándar muestrales son 2 y 8 unidades. Este cálculo describe dispersión sin afirmar que los datos sigan una distribución normal. Tampoco determina qué proporción cae dentro de determinada distancia del centro.
Si la tabla supera el ancho de pantalla, desplázala horizontalmente. Con el teclado, enfócala y usa las flechas.
| Resumen | Qué calcula | Qué permite describir |
|---|---|---|
| Media aritmética | Suma de observaciones dividida entre su cantidad | Ubicación del centro aritmético en las unidades originales |
| Varianza muestral | Suma de desviaciones cuadradas dividida entre n menos uno | Dispersión expresada en unidades cuadradas |
| Desviación estándar muestral | Raíz cuadrada de la varianza muestral | Dispersión alrededor de la media en las unidades originales |
Fuentes: [2]
El error estándar pertenece a una estimación
Imaginemos ahora un experimento hipotético distinto: extraer muchas muestras de una misma población de mediciones abstractas, con una observación por objeto en un momento definido y un procedimiento constante. Calculamos una media en cada muestra. Las medias forman otra distribución, llamada distribución de muestreo. Su desviación estándar es el error estándar de la media. La dispersión original pertenece a las mediciones; esta nueva dispersión pertenece a los promedios obtenidos en repeticiones del muestreo. No necesitamos haber realizado todas esas repeticiones para formular el concepto, aunque estimarlo exige datos y supuestos sobre cómo se obtuvieron.
En un ejemplo hipotético de observaciones independientes e idénticamente distribuidas, con varianza finita, el error estándar de la media aritmética se estima mediante s/√n. Aquí s es la desviación estándar muestral y n cuenta observaciones independientes. Si s es 12 unidades y n es 36, el cálculo da 12/6, es decir, 2 unidades. En otra muestra hipotética de 144 observaciones independientes, suponiendo la misma desviación estándar muestral de 12 unidades y el mismo momento y procedimiento de medición, da 12/12, es decir, 1 unidad. Son cálculos de un modelo didáctico simple. No reconstruyen una estimación ajustada ni resultados individuales de una investigación clínica.
Fuentes: [2]
Más información no borra la variación personal
Dentro de un escenario hipotético de medias aritméticas con observaciones independientes, idéntica distribución y varianza fija, multiplicar por cuatro el tamaño muestral divide el error estándar teórico entre dos. La relación pasa por una raíz cuadrada, no por una reducción proporcional directa. La distribución de las mediciones originales sigue siendo la misma: obtener más observaciones mejora la localización de su media sin obligar a que los valores individuales se parezcan más entre sí. Así pueden coexistir una media estimada con mucha precisión y observaciones muy dispersas. La cantidad de información sobre el centro y la diversidad de la población describen aspectos diferentes.
La independencia es una condición sustantiva. Varias mediciones de la misma persona pueden compartir características persistentes y circunstancias, de modo que agregarlas como si fueran personas nuevas altera el cálculo de incertidumbre. Las mediciones repetidas sí pueden aportar información, especialmente sobre cambios, pero su relación temporal necesita formar parte del análisis. Una herramienta de organización del seguimiento y las preguntas ayuda a conservar fechas y contexto; estadísticamente, esa organización permite distinguir una trayectoria de una colección de observaciones independientes. El número de filas en un registro no determina por sí solo cuánta información independiente contiene ni qué población representa.
Fuentes: [2]
Un intervalo necesita método y cobertura
El error estándar es una escala de variabilidad, mientras que un intervalo necesita una regla para fijar sus extremos. Consideremos un ejemplo hipotético de una media de 50 unidades y un error estándar estimado de 2 unidades, calculados con observaciones independientes de la misma población y el mismo momento de medición. Si una aproximación normal de gran muestra resulta adecuada, un intervalo de confianza aproximado del 95% sería 50 más o menos 1,96 por 2: de 46,08 a 53,92 unidades. El multiplicador y la aproximación son parte del método. En muestras pequeñas u otras condiciones, esa regla puede ser inadecuada.
La cobertura frecuentista describe el comportamiento del procedimiento al repetir el muestreo bajo sus supuestos: los intervalos cambian y el parámetro poblacional permanece fijo. Después de observar los datos, el intervalo calculado contiene ese parámetro o no lo contiene; la cobertura no asigna una probabilidad posterior a ese parámetro fijo. Un intervalo de credibilidad bayesiano utiliza una distribución posterior, construida con datos, modelo y una distribución previa, y admite otra interpretación. Un intervalo de predicción se dirige a una observación futura. Por ello, una línea alrededor de una media requiere tanto el nombre del intervalo como la explicación de su construcción.
Fuentes: [2]
Una media ajustada no es cualquier promedio
Una media ajustada puede construirse mediante un modelo que relaciona el resultado con otras variables, llamadas covariables. El modelo permite calcular valores esperados bajo una combinación definida de esas variables y, según el objetivo, promediarlos con determinadas ponderaciones. El resultado conserva las unidades del desenlace, pero su construcción incluye decisiones que una suma dividida entre el número de observaciones no contiene. Para interpretarlo hacen falta la población de referencia, las variables consideradas y la regla utilizada para combinarlas. Ajustar no significa automáticamente corregir cualquier problema ni obtener una descripción universal aplicable a todos los grupos.
La incertidumbre de ese resultado depende de los parámetros estimados y de sus covarianzas, es decir, de cómo varían conjuntamente sus estimaciones. En modelos con mediciones repetidas, también puede depender de la estructura que representa la relación entre observaciones. Por eso no basta tomar una desviación estándar descriptiva de una tabla y dividirla entre la raíz de un conteo cercano. Ese cálculo podría corresponder a otro objeto estadístico. Una estimación basada en un modelo debe acompañarse de la incertidumbre obtenida para ese mismo modelo y objetivo. Sin esa correspondencia, una fórmula correcta en abstracto puede producir una respuesta equivocada para la pregunta planteada.
Fuentes: [2]
El intervalo de una persona responde otra pregunta
Estimar la media de una población y anticipar una observación nueva exige considerar fuentes distintas de incertidumbre. Para la media interesa cuánto falta por conocer su ubicación. Para una observación futura también importa la variación que existe alrededor de esa ubicación, incluso si el centro fuera conocido con gran precisión. Esa segunda fuente no desaparece al aumentar el tamaño de la muestra usada para estimar la media. En un modelo simple que incluya ambas fuentes, el intervalo predictivo incorpora variación adicional. Su interpretación depende además de que la observación futura corresponda a la población y las condiciones definidas.
Una desviación estándar tampoco es por sí sola un intervalo predictivo. Resume una propiedad de la dispersión, pero para convertirla en extremos con una cobertura determinada hace falta especificar una distribución o un procedimiento apropiado. Distribuciones asimétricas, valores extremos y diferencias entre grupos pueden cambiar la forma de una predicción aun cuando compartan un resumen de dispersión. La tabla distingue los objetos sin asignar resultados a una persona. El paso desde una media colectiva hasta un pronóstico requiere información adicional y validación del modelo predictivo; no se obtiene ampliando visualmente una línea ni trasladando su longitud a una experiencia individual.
Si la tabla supera el ancho de pantalla, desplázala horizontalmente. Con el teclado, enfócala y usa las flechas.
| Pregunta | Objeto pertinente | Información que debe acompañarlo |
|---|---|---|
| Cuánto conocemos la media poblacional | Error estándar e intervalo para la media | Método de estimación y supuestos de cobertura |
| Cuánto difieren las observaciones | Distribución y medidas de dispersión | Unidades, forma de la distribución y población descrita |
| Qué podría observarse en un caso nuevo | Distribución o intervalo de predicción | Variación individual, incertidumbre del modelo y condiciones futuras |
Fuentes: [2]
El solapamiento visual no resuelve una comparación
Comparar estimaciones requiere definir un contraste, como una diferencia entre medias. La incertidumbre de esa diferencia depende de la variabilidad de ambas estimaciones y de su covarianza. Si comparten información, no se comportan necesariamente como estimaciones independientes. Dos intervalos dibujados por separado no muestran toda esa relación. Además, las barras podrían representar medidas distintas o usar niveles de cobertura diferentes. Evaluar si se tocan visualmente deja sin especificar el procedimiento de comparación. Un análisis debe indicar qué contraste estima, bajo qué supuestos y con qué intervalo o prueba; la apariencia de los puntos no sustituye esos elementos.
La equivalencia también necesita una pregunta explícita y límites de diferencia considerados aceptables para ese propósito. No detectar una diferencia no demuestra equivalencia. A su vez, una diferencia estimada con precisión puede tener poca importancia práctica, y una estimación precisa puede conservar sesgos sistemáticos. Precisión, validez y relevancia necesitan evaluaciones separadas. La misma separación sirve al leer documentos comerciales: las reseñas de Mochi Health y Ro permiten consultar términos documentados y sus fechas. Esas lecturas tienen una función documental; la evaluación de un contraste estadístico requiere su propio diseño, datos y método.
Fuentes: [2]
Usar la lectura sin convertirla en una receta
La etiqueta de Zepbound advierte sobre reacciones gastrointestinales graves y lesión renal asociada a deshidratación. No recomienda su uso en gastroparesia grave. Ante síntomas gastrointestinales graves o persistentes, indica contactar al profesional de salud. La FDA no aprueba los preparados compuestos ni revisa su seguridad, eficacia y calidad antes de comercializarlos.
El análisis estadístico y la decisión individual tienen objetos distintos. Un intervalo delimita incertidumbre sobre una cantidad definida; una decisión requiere identificar qué información resulta pertinente para la situación concreta y qué preguntas siguen abiertas. La guía para preparar una teleconsulta sobre GLP-1 permite organizar esa conversación. Llevar una pregunta sobre el significado de una barra es útil cuando se especifica si interesa la precisión de una media, la dispersión de las observaciones o una predicción. Sin esa distinción, interlocutores que usan la misma palabra pueden estar respondiendo preguntas diferentes.
También conviene conservar la identidad de los documentos: el nombre de un producto, una medida estadística y una condición contractual pertenecen a categorías diferentes. Las guías para leer la receta y la etiqueta y distinguir marcas y preparaciones compuestas ayudan a ordenar los términos. La precisión de un cálculo no establece por sí misma que su objeto coincida con el de otra documentación. Mantener esa correspondencia permite discutir qué se conoce y qué falta conocer sin convertir una representación gráfica en instrucciones personales.
Preguntas frecuentes
¿Una barra corta significa que todas las observaciones fueron parecidas?
Depende de qué represente. Si describe precisión de una media, puede ser corta porque el procedimiento aporta mucha información sobre ese centro, aunque las observaciones estén dispersas. Para evaluar si los valores individuales se parecen hay que examinar su distribución o una medida de dispersión adecuada. El tamaño visual necesita una definición y una escala antes de admitir una interpretación.
Fuentes: [2]
¿El error estándar mide cuánto se equivocó la investigación?
No cuantifica directamente errores de registro, sesgos ni incumplimientos del procedimiento. Se refiere a la variabilidad de una estimación bajo un modelo de repetición del proceso de obtención de datos. Por eso puede ser pequeño y coexistir con un problema sistemático de medición. Evaluar la calidad del trabajo exige revisar esas otras fuentes de error por separado.
Fuentes: [2]
¿Puedo obtener un error estándar dividiendo cualquier desviación estándar entre una raíz?
La operación requiere que el objeto y los supuestos correspondan. Para una media aritmética de observaciones independientes e idénticamente distribuidas, con varianza finita, existe esa relación con el tamaño de muestra. Una estimación ponderada, ajustada o basada en observaciones relacionadas necesita considerar su propia construcción. Identificar una fórmula conocida no demuestra que sea aplicable a cualquier cifra publicada.
Fuentes: [2]
¿Por qué no basta observar si se cruzan los intervalos?
Los intervalos separados describen incertidumbre de objetos separados, mientras que una comparación necesita la incertidumbre del contraste entre ellos. La relación entre las estimaciones puede modificar esa incertidumbre. También importa cómo se construyó cada intervalo. El solapamiento visual, sin un procedimiento especificado, no establece una prueba general ni permite concluir que las cantidades sean equivalentes.
Fuentes: [2]
¿Cambiar de unidades modifica la conclusión sobre precisión?
Una conversión lineal coherente con un factor positivo cambia la media, la desviación estándar y el error estándar por el mismo factor de escala, con el tratamiento correspondiente del origen para la media. Cambian sus números escritos, pero no la información relativa que contienen. Una transformación no lineal plantea otra cuestión: puede modificar la simetría de los intervalos y requiere interpretar el resultado en la escala utilizada.
Fuentes: [2]
La pregunta que conviene conservar
La lectura estadística gana precisión cuando cada conclusión conserva el objeto del que procede. La dispersión describe observaciones; el error estándar describe variabilidad de un estimador; un intervalo añade un procedimiento y una interpretación de cobertura. La conexión entre esas cantidades depende de supuestos, y una fórmula simple tiene valor cuando sus condiciones corresponden al problema. Para evaluar una comparación, además, interesa la incertidumbre del contraste y no solo la de cada punto por separado. Esta secuencia permite distinguir qué parte de una representación es información observada, qué parte resulta de un modelo y qué parte todavía requiere evidencia. Comprender esas fronteras mejora la discusión de resultados sin atribuir a una figura más capacidad explicativa o predictiva de la que su definición permite.
Fuentes y límites de esta lectura
- Wharton 2022: STEP.
- Rubino 2025: SURMOUNT.
- Wegovy: etiqueta vigente.
- Zepbound: etiqueta vigente.
- FDA: preparados no aprobados.
Los ejemplos numéricos son hipotéticos y enseñan propiedades estadísticas bajo supuestos explícitos. No estiman resultados personales. La interpretación de cualquier gráfico depende de sus definiciones, del procedimiento de análisis y de la correspondencia entre la pregunta y el objeto representado.